💡这项突破是什么?
随着人工智能领域的快速发展,大模型的训练、数据处理和测评已成为研究热点。尽管当下的大模型已展现出惊艳的能力,但一个根本性问题仍未被真正解决:这些模型是否真正理解人类的指令与意图?当前大模型研究的主流观点认为,仅通过‘99%的预训练+1%的后训练’便可使得大模型被对齐。但大模型真的能被对齐吗?人工智能研究院杨耀东课题组的最新研究为这一方向敲响警钟。
2025年7月,研究团队论文‘Language Models Resist Alignment: Evidence From Data Compression’荣获ACL 2025(由国际计算语言学协会组织的计算语言学和自然语言处理领域顶级国际会议,CCF-A类推荐会议,本届为第63届会议,于2025年7月27日至8月1日在奥地利维也纳举行)年度最佳论文奖。本年度共4篇最佳论文,北京大学包揽华人团队两篇最佳论文(另一篇由DeepSeek与北大团队合作完成)。
该研究首次从压缩理论视角揭示大模型并非可以任意塑造的‘白纸’,其参数结构中存在一种‘弹性’机制——该机制源自预训练阶段,具备驱动模型分布回归的结构性惯性,使得模型在微调后仍可能‘弹回’预训练状态,进而抵抗人类赋予的新指令,导致模型产生抗拒对齐的行为。这意味着对齐的难度远超预期,后训练所需的资源与算力可能不仅不能减少,反而需要与预训练阶段相当,甚至更多。这一发现颠覆了‘99%预训练+1%后训练’的主流对齐范式认知,为AI安全与对齐研究带来根本性挑战与新方向。

论文截图
1. 大模型真的能被对齐吗?‘弹性’机制揭开抗改造本质
当前大模型对齐研究普遍认为,通过少量后训练即可让模型贴合人类意图。但杨耀东团队的研究指出,这一假设忽略了模型深层的‘抗改造’基因:语言模型本质是一种压缩协议,预训练阶段海量数据形成的分布‘引力’,会在对齐微调后产生类似弹簧的‘弹性’—— 既抵抗偏离预训练状态(抵抗性),又在扰动下快速回弹至原始分布(回弹性)。
研究团队通过压缩定理建模发现,模型在预训练与对齐数据上的压缩率变化与数据量呈反比,类似胡克定律:预训练数据量通常远超对齐数据,其‘弹性系数’更高,因此模型更倾向保留预训练特征,对齐效果易被削弱。这一机制在主流模型上均得到验证,证明‘弹性’是大模型的普遍属性,实现稳健且深层次对齐亟需深入模型内部机制的对齐方法。

图1. 语言模型无损压缩协议的建模过程:由数据集结构化表示到联合压缩
这一发现与胡克定律在弹簧系统中的反比关系呈现出惊人的一致性:其中,弹簧的弹性系数可类比于训练与对齐阶段中各自的数据量大小,而模型分布的变化则对应于弹簧的伸长量。在扰动作用下,各数据集压缩率的变化速率与其数据量成反比。这正如串联弹簧系统中胡克定律所描述的,弹簧的伸长量与其弹性系数呈反比关系。

图2. 语言模型的‘弹性率’:数据量大小与分布间KL散度变化呈反比关系
ACL 2025审稿人及大会主席一致认为,论文提出的‘弹性’概念突破性地揭示了大语言模型在对齐过程中的抵抗与回弹机制,为长期困扰该领域的‘对齐脆弱性’问题提供了新的理论视角与坚实基础。领域主席则进一步指出,论文在压缩理论、模型扩展性与安全对齐之间搭建起桥梁,不仅实证扎实、理论深入,更具深远的治理和安全启发意义。
2. 模型是如何抗拒对齐的?从负反馈机制说起
负反馈机制是一种普遍存在于自然和工程系统中的调节原理,用以维持系统稳定、减少异常波动。从物理学中的弹簧到化学中的勒夏特列原理,各类系统均通过‘抵抗变化’实现趋于平衡的自调节过程。例如,弹簧总试图恢复至原始长度,而化学反应则倾向于朝抵消外界扰动的方向变化,以维持系统平衡。

图3. 自然系统中的负反馈机制:胡克定律与勒夏特列原理
这一普遍规律引发了一个重要问题:在人工智能系统,尤其是语言模型的对齐过程中,是否也存在类似的‘负反馈机制’?即模型在接收对齐信号时,是否会无意识地产生对抗性偏移,进而削弱人类干预的长期效果导致对齐失效?
3. 抵抗与回弹:弹性对后训练影响的实证研究
研究团队通过精巧的实验设计,系统地揭示了大模型在对齐后表现出的两种关键现象:抵抗和回弹,并实证性地探究了影响这些现象的关键内部因素。
总体而言,实验结果有力地证明了:大模型存在一种内在的、抵抗对齐微调的弹力,因此倾向于回归预训练状态的特性。并且‘弹性’现象会随着模型规模和预训练数据量的增加而加剧。这意味着在追求更大、更强模型的道路上,对齐的脆弱性问题将变得更加突出。
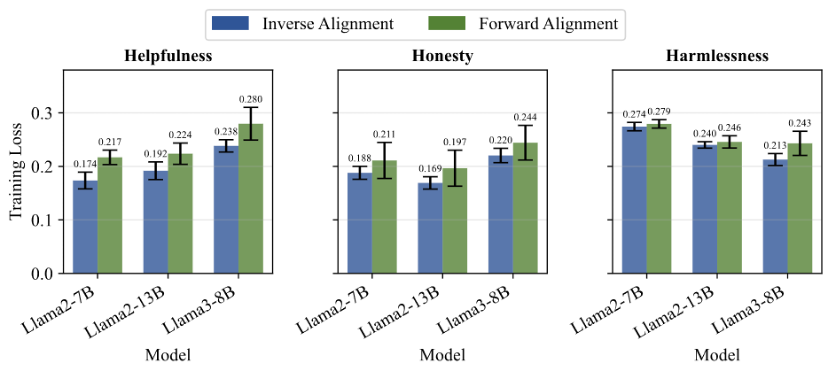
图4. 前向对齐与逆向对齐在3H标准上的对比表现

图5. 更多正向数据训练,模型的‘弹性’越明显

图6. 模型的‘弹性’随参数规模的增加而愈发显著

图7. 模型的‘弹性’随预训练数据量的增加而愈发显著
4. 大模型可被对齐吗?后训练范式是否持续有效?
模型弹性的揭示凸显了当下日益增加的风险:模型学会‘表现出’对齐,而非真正内化目标。例如,模型可能在训练中通过模仿奖励信号而非理解其背后价值,从而导致欺骗性对齐。
模型甚至可能主动伪装对齐状态以规避人类监督。在策略性问答中,当检测机制较强时,模型倾向输出‘安全表态’;但当检测被移除或绕过后,模型将迅速回到更高效、但违背人类偏好的生成策略。这种条件敏感性体现出模型并非始终‘诚实’,而是在‘看得见监督’时才‘装作诚实’。
这些都表明,对齐结果在模型内部可能仅是‘表演’而非‘信仰’。这类‘假对齐’问题不仅挑战现有对齐评估体系的可信度,也暴露了在更高智能水平的系统中,若模型学会‘欺骗对齐检测机制本身’,其带来的后果将难以预料。
为此,该团队呼吁整个AI社区,应从当前‘99%预训练+1%后训练’的表层微调模式,迈向一个全新的‘抗弹性对齐’范式,从根本上理解并驯服模型的这种‘弹性脾气’,以构建更安全、更可靠的通用人工智能。
研究团队提出的‘弹性’理论首次揭示了大模型对齐的根本性阻力——预训练分布所施加的‘引力’。这一发现为AI对齐研究提供了新的基础视角,指出当前‘浅层微调’范式难以克服模型深层结构的抗改造性。正如弹簧需持续外力维持形变,实现稳健对齐或需更深层次的机制重塑。该理论不仅挑战了现有范式,也为构建安全、可靠的通用人工智能开辟了新的路径。在AGI发展的关键阶段,能否驯服大模型的‘弹性’,或将决定AI的未来走向。
论文的第一作者包括北京大学人工智能研究院博士生吉嘉铭,周嘉懿,元培学院通用人工智能实验班王恺乐,陈博远,信科本科生邱天异。合作者包括智源研究院AI安全中心戴俊韬博士以及北京大学计算机学院教授刘云淮。论文的(独立)通讯作者为杨耀东。